KI-teknologier for SOC-automatisering
På begynnelsen av 2000-tallet begynte vi å bruke maskinlæringsalgoritmer for å oppdage skadelig programvare. Siden den gang har angripere forbedret metodene sine. Dagens målrettede angrep karakterisert av å være godt skjult, særlig ved minimal bruk av skadelig programvare som kan oppdages av antivirus. I stedet bruker mange angripere sosial manipulasjon for å få innledende tilgang, og utnytter deretter feilkonfigureringer av systemet og legitim programvare for sideveis bevegelse og utholdenhet i den kompromitterte infrastrukturen.
Å oppdage slike angrep krever innsamling og analyse av store mengder data om atferden til enheter, applikasjoner og brukere i bedriftsnettverket. Og hver gang det oppdages mistenkelig aktivitet, må hendelsen bekreftes som et angrep eller anses som legitim aktivitet. Etter hvert som antallet aktiva i en organisasjon vokser, øker også volumet av innsamlet telemetri, noe som øker belastningen på analytikere som jobber i sikkerhetsoperasjonssentre og MDR-tjenester.
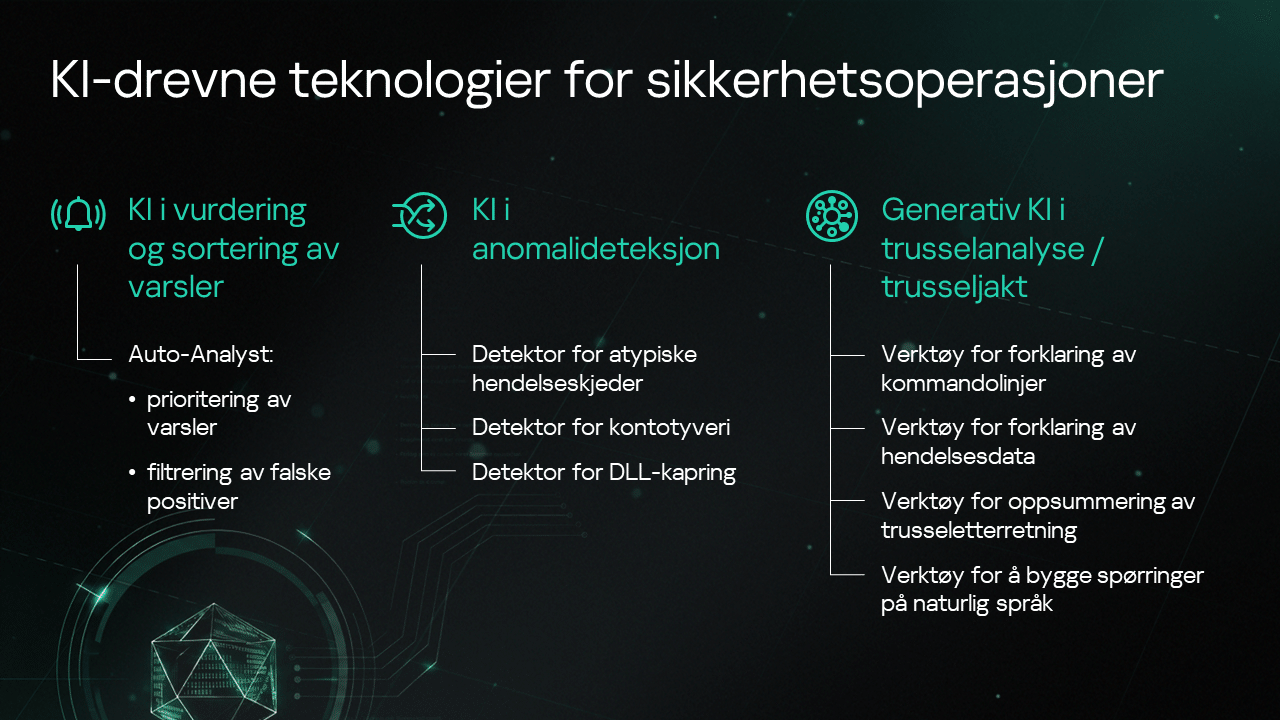
KI-teknologibasert automatisering gjør det mulig å betydelig forenkle dette arbeidet på flere områder:
- Triagering: prioritering av varsler om mistenkelige hendelser i MDR/XDR/ SIEM -telemetri, filtrering av falske positiver.
- Deteksjon av atferdsavvik: identifisere tegn på kontotyveri, vertskompromittering, DLL-kapringsangrep og andre ondsinnede aktiviteter.
- Datapresentasjon: oppsummering og tolking av kommandolinjer, hendelser og TI-rapporter.
- Trusseljakt på naturlig språk: oversette analytikeres hypoteser til SQL-spørringer.
Nedenfor beskriver vi hvordan disse KI-teknologiene i praksis implementeres i våre produkter og tjenester.
Automatisk analyse og prioritering av varsler
Infrastrukturene til MDR-tjenesteklientene våre genererer milliarder av sikkerhetshendelser daglig. Datainnsamlingssystemet identifiserer mistenkelige hendelser basert på spesielle deteksjonsregler og rapporterer denne potensielt ondsinnede aktiviteten til analytikere i form av varsler: flere hundre tusen meldinger årlig. Imidlertid vil bare rundt en tidel av disse varslingene gjelde genuine sikkerhetshendelser.
Dermed står analytikere overfor oppgaven med å filtrere ut de «falske alarmene» som utgjør flertallet av varslene. For å gjøre dette, utviklet vi et KI-system som heter Auto-Analyst. Dette overvåkede maskinlæringssystemet trener på varsler merket med avgjørelser fra SOC-analytikere. Målet er å trygt identifisere falske positiver generert av legitim nettverksaktivitet.
Maskinlæring her er basert på CatBoost, et populært gradientforsterkende bibliotek. Den trente autoanalytikeren filtrerer varsler og videresender kun for menneskelig gjennomgang de med en sannsynlighet over en spesifisert terskel for å være en reell hendelse, denne sannsynligheten bestemmes av den akseptable feilprosenten. Dette resulterer i at rundt 30 % av varslene håndteres kun av KI, noe som frigjør SOC teamets tid til mer komplekse oppgaver. Varslene som når menneskelig analyse har blitt prioritert, slik at analytikere kan fokusere på det mest kritiske først.
Mer informasjon om de praktiske nyansene i Auto-Analysts arbeid (kontrollere treningsdata, selektiv gjennomgang av resultater etc.) finner du i en egen artikkel fra ekspertene våre.
Avviksdeteksjon i SIEM
Essensen i denne tilnærmingen er å bruke telemetri innhentet i løpet av den «sunne» funksjonen til systemet for å trene en KI-modell som deretter vil signalisere avvik fra normal atferd.
Bruk av slike algoritmer i store distribuerte systemer er komplisert av det enorme antallet parametere som må vurderes når du bygger modellen. Og slike modeller kan produsere et stort antall falske positiver: I en organisasjon med tusenvis av brukere, kan mange tilfeller av atypisk atferd være legitime.
Denne tilnærmingen kan imidlertid brukes med stor suksess for separate aktiva og prosesser der det er mulig å bygge en tilstrekkelig nøyaktig modell for normal funksjon.
Unormale hendelseskjeder
I dette tilfellet brukes data om typiske sekvenser av SIEM-korrelasjonsregelutløsere for å bygge en modell for normal atferd. Hyppige utløsere av samme sekvens er vanligvis falske positive (f.eks. automatisk kjøring av administrativt skript), disse kan brukes som en indikator på typisk aktivitet i infrastrukturen.
Ved å bygge en profil av typisk vertsatferd som et sett med sannsynligheter for å utløse visse regler, kan KI-systemet vårt evaluere hvor typisk eller atypisk hver ny hendelseskjede er for den gitte infrastrukturen. Deteksjon av en atypisk kjede fører til at systemet øker prioriteringen av varselet og slik at sikkerhetsspesialistene kan se på den for en mer detaljert analyse.
Kontotyveri
En annen teknologi for deteksjon av avvik gjør det mulig å oppdage potensielt uautorisert aktivitet fra brukerkontoer. Her bruker ML-systemet enhetspar, som for eksempel "brukerkonto-IP", "brukerkonto-vert", "brukerkonto-land" osv., for å lage profiler med typisk brukerkontoatferd.
En angriper som bruker en stjålet konto, vil vanligvis forstyrre det vanlige aktivitetsmønsteret. Angripere logger inn på systemet fra uvanlige adresser og ser deretter etter måter å bevege seg sideveis eller eskalere privilegier i systemet ved å besøke noder i infrastrukturen som den legitime brukeren av kontoen ikke ville ha besøkt. KI-systemet oppdager slike uregelmessigheter og samler inn den nødvendige sammenhengen i et varsel, slik at analytikere raskt kan reagere på slike hendelser.
DLL-kapring
DLL-kapring er en angrepsteknikk i Windows OS der angripere lurer klarerte Windows-programmer til å laste inn ondsinnede DLL-filer fremfor de ekte filene. Deteksjon av slike angrep ved hjelp av klassiske sikkerhetsløsninger er ikke lett fordi det ondsinnede biblioteket kjøres i det klarerte adresserommet til en legitim prosess, så denne aktiviteten kan se ut for en sikkerhetsløsning som en klarert prosess. Det er ingen overraskelse at antallet angrep med DLL-kapring har økt betraktelig de siste årene.
For å bygge en KI-modell som skiller mellom ondsinnet og legitim filinnlasting, har ekspertene våre identifisert en rekke funksjoner som oppstår i mistenkelige tilfeller: feil filplassering, feil plassering av den kjørbare filen, omdøpt kjørbar fil, endringer i filenes størrelse og struktur, manglende signatur osv. For treningsprøven brukte vi DLL-lastdata levert av våre interne automatiske behandlingssystemer og anonymisert brukertelemetri fra KSN.
Mer informasjon om opplæringsprosessen til denne modellen er tilgjengelig i en egen rapport. Selv på pilotstadiet har denne teknologien bidratt til å forhindre flere angrep i våre kunders systemer.
KI-assistenter basert på generative modeller
Alle de foregående prøvene gjelder bruk av KI som en klassifikator: gitt et nytt informasjonsobjekt, sender modellen det ut som tilhørende en bestemt klasse («det er en hund»). Slike ML-systemer er vanligvis trent på et begrenset utvalg av data som er direkte relevant for oppgaven.
Generativ KI fungerer "omvendt". Systemet mottar en bestemt type ønsket resultat som en spørring («tegn en hund for mer») og sender ut nye informasjonsobjekter av den ønskede typen. Systemet benytter seg av omfattende "kunnskap" på emneområdet for å gjøre dette, oppnådd gjennom forhåndstrening av en stor språkmodell (Large Language Model, LLM) med enorme mengder offentlig informasjon.
Dette gjør det mulig å bruke LLM-baserte systemer til et bredt spekter av oppgaver, inkludert arbeid med ustrukturerte data. Dagens LLM-er er spesielt gode til å håndtere tekstbehandlingsoppgaver, for eksempel oversettelse, tolkning og oppsummering (dvs. å lage en kort versjon av den opprinnelige teksten og samtidig bevare sentrale ideer).
For å løse lignende tekstbehandlingsoppgaver i sikkerhetsprodukter og -tjenester har vi utviklet vår egen KI-assistentteknologi. Denne teknologien forbereder data for spørringer til LLM, danner og sender spørringer, behandler resultater og sender dem til analytikere samtidig som den sikrer at hele kommunikasjonen er sikker.
KI-assistenten kan jobbe med hvilken som helst LLM som klienten velger, i henhold til deres oppgaver og krav. For eksempel er skymodeller vanligvis kraftigere enn de som er distribuert lokalt, men bruk av lokalt distribuerte modeller unngår overføring av konfidensielle data til tredjepartstjenester.
Tolkning av kommandolinjer
En tilslørt kommandolinje er en vanlig type mistenkelig hendelse som krever nøye inspeksjon av en analytiker. Angripere bruker slike kommandolinjer for å gi instruksjonene sine direkte til operativsystemet på verten som angripes, samtidig som de unngår oppdagelse. For å skjule ondsinnede kommandoer bruker de koding, syntaksmanipulasjon og mange andre tilsløringsmetoder, noe som gjør det vanskelig å identifisere de faktiske intensjonene til kommandoforfatteren.
KI-assistenten vår utfører først statisk avsløring av den mistenkelige linjen. Deretter sender den en rekke spørringer til LLM for å forklare alle kommandolinjeparameterne. Til slutt presenterer assistenten et sammendrag til en analytiker: Hva linjen gjør og hvor farlig den er.
Oppsummering av hendelsesdata
For å automatisere hendelsesrespons vil dagens SOC bruke funksjonaliteten til Incident Response Platform (IRP). Dette programmet samler alle data relatert til en hendelse på ett kort, inkludert relaterte sikkerhetshendelser og artefakter.
En slik innsamling av data kan imidlertid være svært stor, og manuell analyse av alle hendelsesdetaljer tar tid. Dessuten er det situasjoner der analytikere trenger å huske gamle hendelser, noe som krever at biter av gamle puslespill settes sammen igjen.
GenAI-assistenten forenkler dette arbeidet betraktelig. Den samler inn all telemetri relatert til hendelsen og lager ved hjelp av LLM en kort forklaring på hva som skjedde i saken, inkludert den innledende angrepsvektoren og angriperens handlinger gjennom hendelsen, sammen med anbefalinger om hvordan de skal reagere.
Oppsummering av trusseletterretning (TI)
Når analytikere etterforsker en hendelse, benytter de ofte tilleggskilder til informasjon om den aktuelle trusselen. En slik kilde er vår Threat Intelligence Portal (TIP), som inneholder over fem petabyte med TI samlet inn av Kaspersky i løpet av mer enn et kvart århundre med trusseldeteksjonsarbeid: hasher med ondsinnede filer, statistikk og atferdsmessige egenskaper, IP-er og URL-adresser til kommando- og kontrollsentre, TTP-er for hackergrupper osv.
Et typisk scenario for å jobbe med portalen ser slik ut: En analytiker laster opp en mistenkelig prøve som ble funnet under hendelsesetterforskningen, og kjører den i portalens sandkasse. Som et resultat mottar de detaljerte analyser: vurderinger og hasjer for oppdaget skadelig programvare, domeneadresser de var i kontakt med, nedlastede filer fra internett osv.
Alle disse dataene kan brukes som parametere for å søke etter ytterligere TI fra åpne kilder. Portalen kan for eksempel vise rapporter om en APT-gruppe som bruker de samme C2-adressene som de som ble oppdaget ved detonering av prøven i sandkassen. Dette gir analytikeren flere IoC-er å sjekke inn infrastrukturen deres.
Det kan imidlertid ta lang tid å gå gjennom forskjellige TI-rapporter, spesielt hvis de er skrevet på ulike språk og i forskjellige formater. KI-assistenten vår lager et strukturert sammendrag av TI-rapporter som viser hvordan en gitt indikator er relatert til en bestemt gruppe, hvor og når den var aktiv, hvilke teknikker den bruker osv. På samme måte kan KI-assistenten lage en strukturert beskrivelse av en gitt APT-gruppe basert på OSINT-data.
Trusseljakt på naturlig språk
Når en analytiker ønsker å innhente tilleggsdata om den pågående hendelsen eller proaktivt identifisere en trussel basert på nylig mottatte indikatorer, må hen formulere en spørring til et logglager eller SIEM/EDR/XDR-database, der sikkerhetshendelser samles inn . Å oversette analytikerens hypotese til SQL-spørringer med presis syntaks og riktige parametere kan imidlertid ta betydelig tid og redusere undersøkelses- og svarsprosesser.
Vår KI-assistent gjør at analytikere kan formulere spørringer til databasen på naturlig språk, det vil si bokstavelig talt på hypotesenivå. Analytikeren kan for eksempel si, «vis alle hendelser som fant sted i går på slike og slike verter, der en kjørbar fil med et slikt og slikt navn var involvert.» Når KI-assistenten mottar denne forespørselen, bruker den LLM for å velge de nødvendige feltene fra datamodellen, og sender deretter en SQL-spørring til databasen. Før den faktiske kjøringen, kan analytikere se gjennom den KI-genererte spørringen, validere logikken og justere parametere eller syntaks hvis de ønsker det.


